

手動データ インポートを効率的に構成し、正確でシームレスなデータ連携を実現するために、手動でのデータ インポートの設定、実行、管理に必要な手順を確認します。
手動ファイル インポート - 概要
Anaplan Financial Consolidation にインポートされるデータは顧客ごとに異なります。これは、読み込まれるデータ、そのデータのソース システム、データ ファイルに含まれる情報によってデータ ファイルが大きく異なるためです。
例:
- ソース システムによって生成されるファイルには時間軸が含まれていない場合があります。この場合、データ インポート定義を使用して、どの時間軸に読み込むかを定義する必要があります。
- ソース システムでは、システムのメンバーの名前とは異なるエンティティ名を使用するファイルが提供される場合があります。この場合、データ マッピングを設定する必要があります。
ワークフロー タスクを使用した CSV 又は Excel ファイルのインポート
次の図は、データ インポート プロセス全体の概要を示したものです。
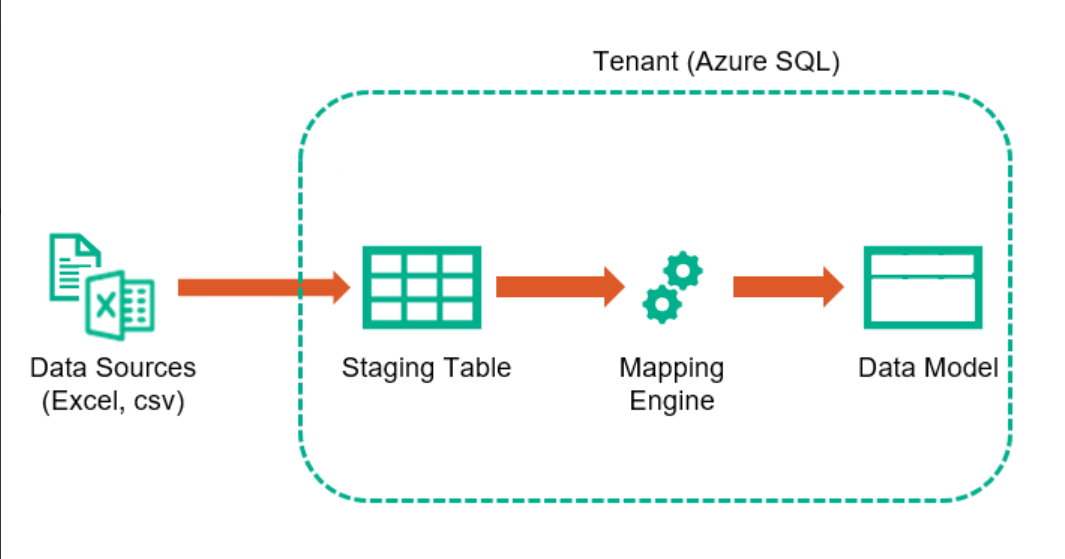
機能するデータ インポートを作成するには、以下を構成します。
機能するデータ インポートを作成するために構成する必要がある変動要素がいくつかあります。
- ステージング テーブル: データをファクト テーブルにマッピングしてアップロードする前に、読み込まれたデータを一時的に保存します。
- このタスクはステージング テーブル インターフェースで実行されます。文字列のデフォルト サイズは 256 です。
- データ インポート定義: インポートを定義します (特別な名前)。時間軸などの欠落フィールドの処理方法などを指定します。
- このタスクはデータ インポート定義エディターで実行されます (フィールド マッピングやデータ クリア設定など)。
- データ マッピング: 必要に応じて、各ディメンションのメンバー マッピングを設定します。たとえば、システム内のメンバー名と一致しないメンバー名をどのように処理するかなどです。
- このタスクはマップ エディターで実行されます。
- インポートを実行するためのワークフロー。
- このタスクはWorkflow エディターで実行されます。
さらに、マッピングとデータ インポートを正しく設定するには、インポート ファイルのサンプルが必要です。

